Bloom Filter
Bloom Filter
背景
在研究 leveldb 源码的时候,发现有这样一个 FilterPolicy 的实现——BloomFilter。
在介绍具体实现之前,我们需要了解一下这个 filter 的引入是为了什么。
对于 leveldb 而言,write (尤其是 batch write)是 cost 非常小的操作,但是 read 的 cost 可能比较大。之所以用可能,是因为如果 cache 命中了,那么 read 操作 cost 会很小,但是如果 cache miss 了,那么就需要到存储的 sst 文件中进行查询(涉及多次 disk io)。
而上面提到的 filter 就是为了避免在 cache miss 的情况下进行的无用 disk io(当我们查询的 key 并不存在,则 disk io 就是无用的)。
而 Bloom Filter 的一个重要特性就是可以确认某个 key 不存在(这点对于 level db cache miss 的情况非常有用),(此外可以以概率的形式确认某个 key 存在)。
原理
根据上面所述,Bloom Filter 的效果是提供一个 IsIn 方法,输入是一个 key,输出是一个 boolean,false 意味着不存在。
Bloom Filter 不仅效果简单,其实原理也可以说是非常简单,实现一个 Bloom Filter,只需要两个部分:
1. k 个 hash function:`hashFuncs`
2. bit 长度为 m 的数组(初始值都是 bit 0): `flags`
代码表示如下:
type BloomFilter struct {
	hashFuncs	[]func([]byte)uint
	flags		[]bit
}
为了表述方便,flags 的元素我们认为是一个 bit,而不是一个 byte。
CreateFilter
在使用 BloomFilter 之前,我们需要利用已经存在的 key 来做一次初始化。
对于每个 key,我们将其作为 k 个 hash function 的输入,依次得到 k 个 hash 值,再将数组的下标为这些 hash 值的相应元素标记为 1。
从上面的描述,可以发现多个 key 可能会产重复的 hash 值,这其实也是为什么 Bloom Filter 不能断定一个 key 存在的原因。
代码如下:
func (f *BloomFilter) CreateFilter(keys []byte) {
	for _, key := range keys {
		for _, hash := range hashFuncs {
			flags[hash(key)%m] = 0b1
		}
	}
}
IsIn
对于是否存在给定 key 的判断逻辑也十分简单,就是应用 k 个 hash function,并且依次检查相应的元素是否被设置成 1,如果有任何一个元素不是 1,那么我们就可以断定该 key 不存在。
代码如下:
func (f *BloomFilter) IsIn(key []byte) {
	for _, hash := range hashFuncs {
		if flags[hash(key)%m] != 0b1 {
			return false
		}
	}
	return true
}
Remove
从上面的描述可以看出,不同的 key 是可以占用相同的 bit 位置的,因此当我们试图删除某个 key 的时候,我们无法断定是否要 reset 该 key 对应的 bit 位(因为很有可能是其他 key 占用了即将要 reset 的 bit)。
因此,一般来说,Bloom Filter 没有 remove 操作。
但其实如果一定要支持 Remove 操作的话,我们可以将 flags 的元素类型扩展成一个 int 值(而不是一个 bit),用来记录该位置被不同的 key 引用的次数,因此在 remove 的时候,只是做自减的操作。
这样做的坏处也是显而易见的,会占用大量内存:如果本来使用的是一个 bit,现在使用 uint32,那么占用的空间将会扩大到 32 倍。
复杂度分析
从直觉上讲,如果我们想要更准确地判断出不存在,或者说在给出IsIn(key) == true的时候使错误的概率(error rate of false positive)更小, flags 的长度越大越好, hash function 的数目越多越好,然而这里实际上又会要求更多的存储空间(一般都是内存来存储的),所以这里存在一个参数 tuning m & k 的过程。
而实际上,false positive 的概率不仅和 flags、hash functions 有关,实际上也和整个 key 的数目有关(比如 key 只有一个的话,那么判断就不会出错了)。
最终 false positive 的 error rate p,是存在这样一个公式的:
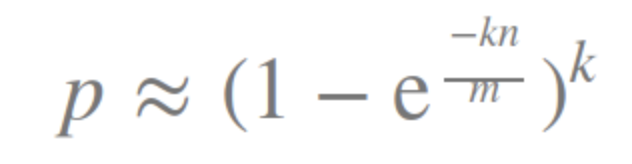
根据这个公式我们可以很方便的完成 tuning m & k 的工作。
参考
[1] Probabilistic Data structures: Bloom filter – Hacker Noon